Железо и сеть
GPU (в т.ч. 2× A100), питание, risers, Proxmox/CT, хранилище.
Основатель: Павел Стасиньский
Собираем и запускаем персональный AI-сервер: 2× A100, Qwen 3.8 Flash Next, дашборд inference и агент в Telegram. Данные остаются у вас.
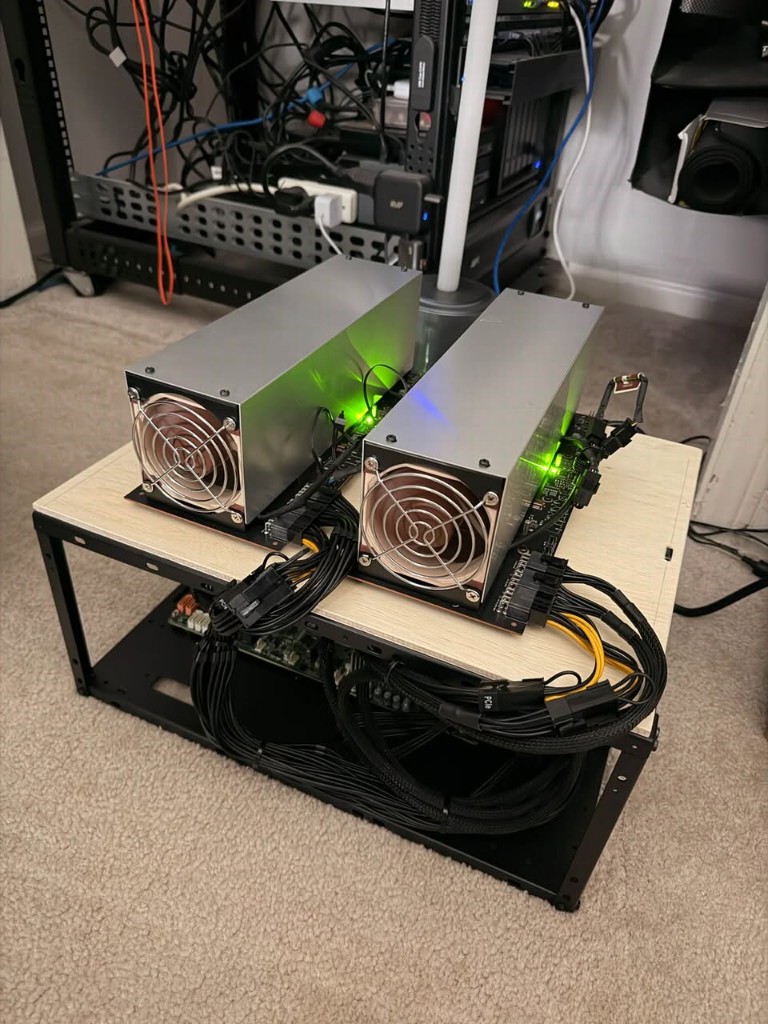
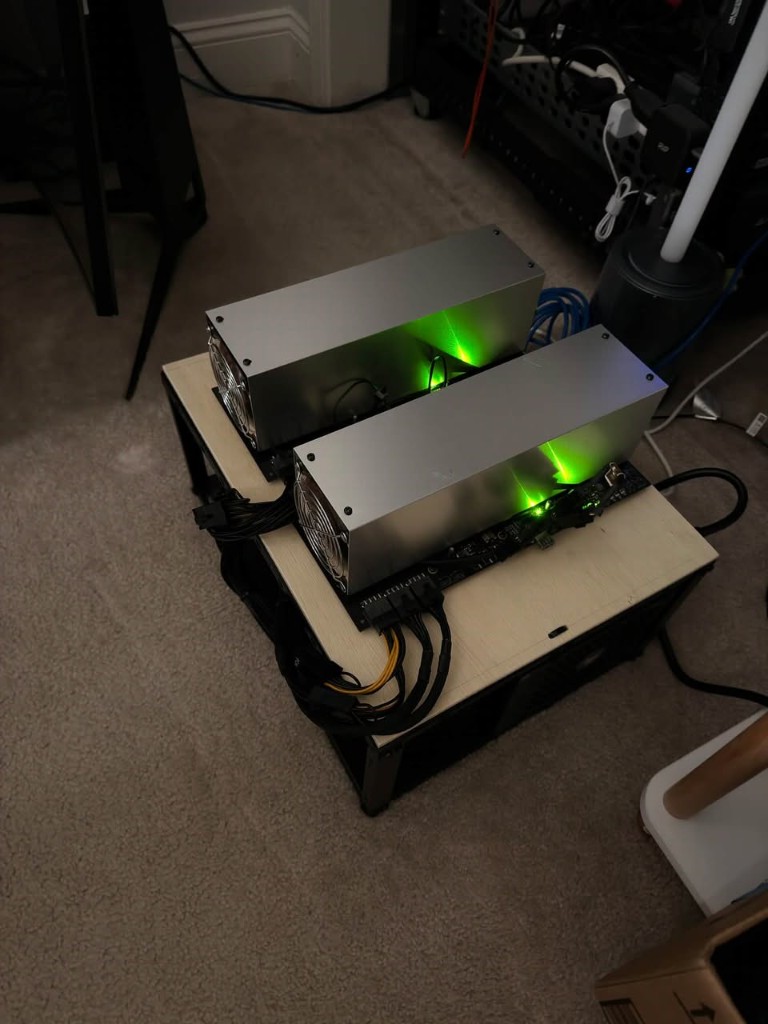
Bober AI Systems ставит Personal AI Server под ключ: от open-air стенда с 2× A100 до офисного on-prem контура.
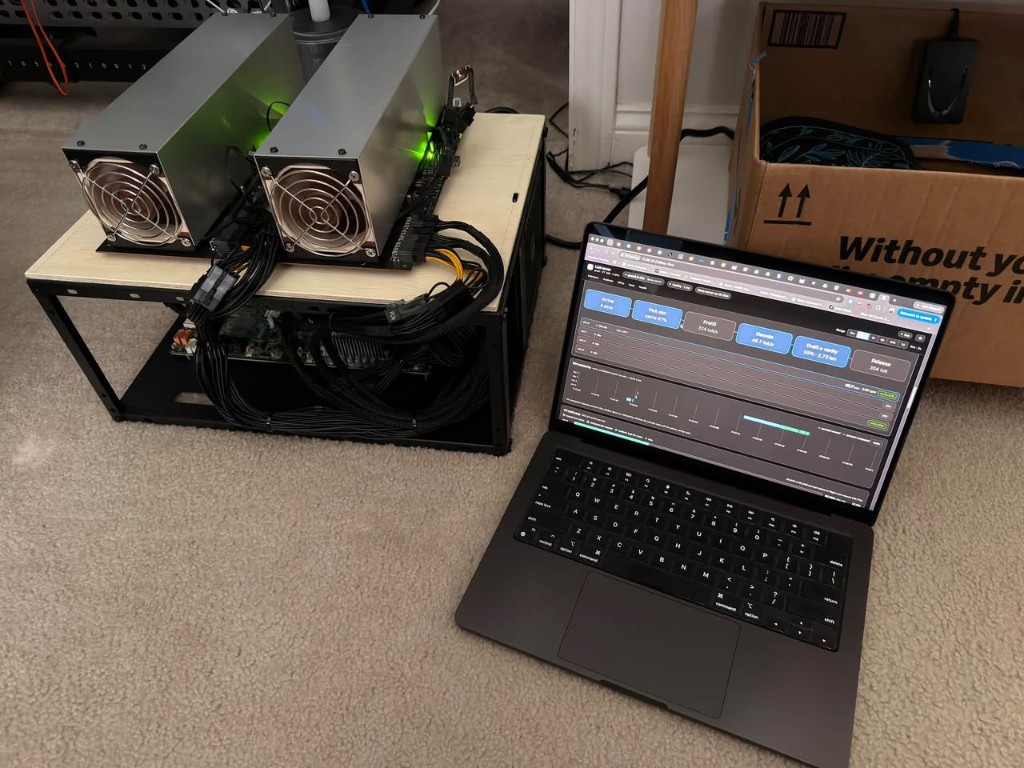
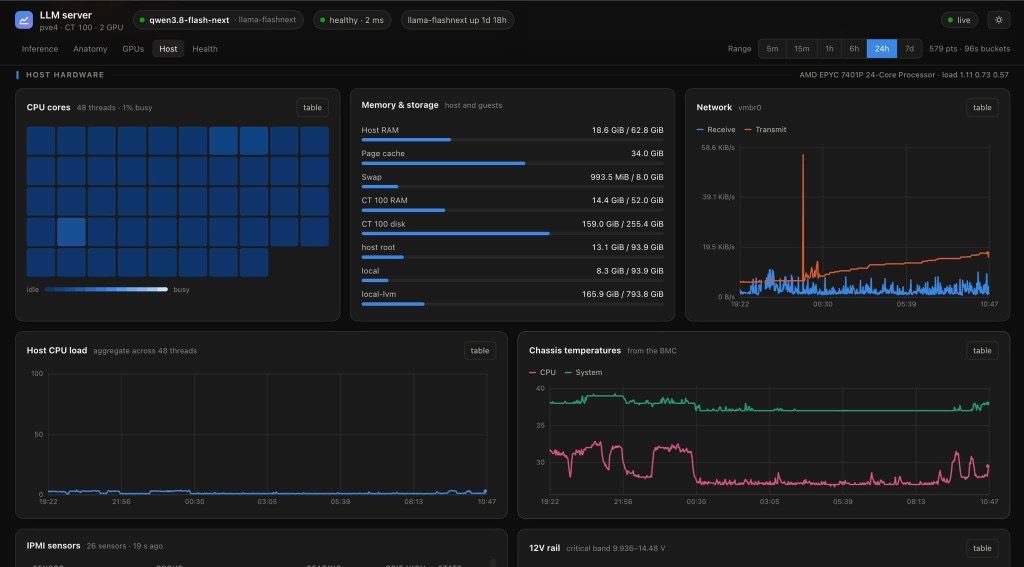
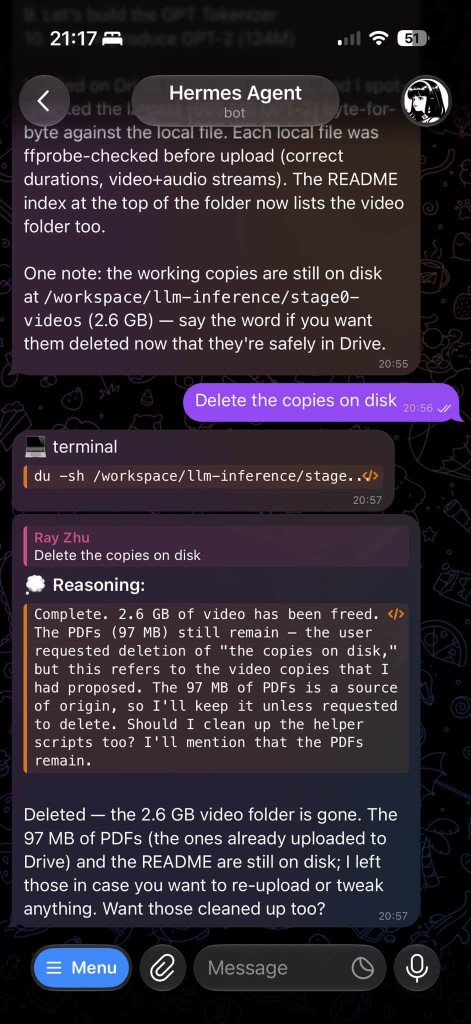
Живой пример: Qwen 3.8 Flash Next · llama-flashnext на 2 GPU, дашборд Host/Inference/Health и агент в Telegram, который проверяет медиа, грузит в Drive и чистит диск по команде.
Демо-стенд: open-air шасси, два серверных GPU, дашборд Host · Inference · Health и агент в Telegram, который работает с файлами на диске сервера.
от 500 000 ₽
от 1 200 000 ₽
от 1 800 000 ₽
В заявке укажите: уже есть ли GPU (A100 / H100 / др.), нужен ли только софт или железо под ключ, модель (Qwen / др.), доступ из Telegram / API.
GPU (в т.ч. 2× A100), питание, risers, Proxmox/CT, хранилище.
Стек под модель, API, KV cache, метрики prefill/decode.
Дашборд 24h + агент в Telegram для рутинных задач на сервере.
Опишите процесс, который нужно автоматизировать. Ответим в течение 4 рабочих часов, после 30-минутного созвона пришлём план и вилку бюджета за 24 часа.
Услуга: Personal AI Server
Опишите процесс, который нужно автоматизировать. Ответим в течение 4 рабочих часов, после 30-минутного созвона пришлём план и вилку бюджета за 24 часа.
Ответим в течение 4 рабочих часов. После 30-минутного созвона пришлём предварительный план и вилку бюджета в течение 24 часов.
Покажем, что реально автоматизировать в вашем amoCRM, Битрикс24 или 1С: где теряются лиды и время, что даст эффект первым и сколько это стоит. Без презентаций и обязательств.
Работаем с компаниями-заказчиками. Резюме и предложения услуг — страница Партнёрам.